
はじめに
Hello, AIラバーなみなさん。これからラバーなみなさん。
2026年9月15日に、TypeSafe社がJevを発表しました。 Jevは通常のLLMのAPIとは違い、判断結果だけを返すAPIです。 その代わり、高速で安価という特徴があり、AI界隈がざわざわしました。
時は2026年9月29日、なんとOpenAIがJevと同じように判断結果を決まった形式で返すAPIを発表したではありませんか。 そのAPIの名前が「Decisions API」です。
Decisions APIを試した記録と活用方法をまとめました。
> この記事は2026年10月15日時点の情報です。Decisions APIは2026年10月6日に公開されたパブリックベータ版で、対応モデルはgpt-6-lunaです。
>
> 参考: 公式ガイド・更新履歴
Decisions APIでできること
Decisions APIでは、入力と判断基準を渡し、次の3種類の質問をします。
| 質問タイプ | 用途の例 | 主な返却値 |
|---|---|---|
predicate |
この商品にへこみがあるか | 条件が真である確率の推定値probability |
choice |
問い合わせをどの部署へ送るか | 選択した値choice |
score |
荷物の破損がどの程度か | 評価基準に沿った数値score |
predicateの返却値は0〜1の確率です。アプリ側でしきい値を決めれば、「一定以上なら人に確認してもらう」という処理に使えます。
choiceとscoreでは、各候補の確率を表すprobabilitiesと、質問ごとの回答に対するconfidenceも返ります。返却形式が決まっているので、その値を振り分けや表示の切り替えにつなげやすいわけですね。
> 参考: 返却形式のリファレンス
Responses APIとの使い分け
Responses APIでも、Structured Outputsを使えばJSONの形式を指定できます。分類処理を作る方法は以前からあったようです。
Decisions APIは、判断結果を確率・選択肢・スコアという決まった形で扱います。独自の項目を持つJSONや、判断理由の文章まで必要なら、Responses APIのStructured Outputsが候補になります。
> 参考: 公式ガイドの使い分け
たとえば、問い合わせの担当部署だけを決めたいならchoice。問い合わせを要約して、返信案まで作りたいならResponses API。欲しい結果に合わせて選ぶのがよさそうです。
準備
OpenAI APIキーを取得する
まずはOpenAI Platformにログインします。APIを使うための設定は、こちらで行います。
- 利用する組織・プロジェクトを選びます。試用の費用を分けたい場合は、専用のプロジェクトを作ると管理しやすいです。
- API keysを開き、新しいシークレットキーを作成します。キーに
decisions-demoなど用途が分かる名前を付けます。 - 発行されたキーをコピーし、安全な場所に保存します。この記事のコードでは環境変数
OPENAI_API_KEYから読み込みます。 - BillingでAPI側の支払い設定と利用可能なクレジットを確認し、必要に応じて追加します。
API keys画面では、右上の「Create new secret key」から作成画面を開けます。

作成ダイアログで、キーの名前や対象のプロジェクト、権限などを設定します。

キーの発行と環境変数の設定は、公式クイックスタートでも案内されています。会社の組織でキーを作れない場合は、管理者の設定や自分の権限も確認してください。
> 参考: APIキーの管理
今回のようにAPIキーで呼び出した分は、ChatGPTのサブスクリプションとは別に課金されます。ChatGPTを契約していても、API側の設定は確認しておきましょう。
> 参考: 料金体系の説明
APIキーはソースコードや公開する画像に載せず、サーバー側で管理します。Webアプリに組み込む場合は、自分のバックエンドを経由してAPIを呼び出す構成にします。
> 参考: 認証とAPIキーの扱い
実行環境の準備
この記事のサンプルと実測には、次の環境を使用しました。
| 項目 | 使用した環境・バージョン | 用途 |
|---|---|---|
| JavaScriptランタイム | Node.js 24.14.0 | .mjsファイルと計測スクリプトの実行 |
| OpenAI SDK | openai 7.32.0 |
client.decisions.create()によるAPI呼び出し |
| API・モデル | Decisions API / gpt-6-luna |
問い合わせ分類・画像のへこみ判定 |
| サンプルの言語・形式 | JavaScript / ES Modules(.mjs) |
importとトップレベルのawaitを使用 |
本文のサンプルで追加する依存パッケージはOpenAI SDKだけです。
以下の手順は、pnpmがインストール済みの環境を前提とします。作業フォルダーを作り、上表のバージョンのSDKをインストールします。
mkdir decisions-demo
cd decisions-demo
pnpm init
pnpm add openai@7.32.0
このフォルダーに.env.localを作成し、取得したキーを設定します。
OPENAI_API_KEY=ここに取得したAPIキーを設定
環境変数は--env-file=.env.localオプションで読み込むので、dotenvなどの追加パッケージは使いません。
実践1:問い合わせを担当部署へ振り分ける
今回は、こんな問い合わせを渡します。
> 注文の代金が二重に請求されました
選択肢は「請求」「技術」「配送」「その他」の4つです。人が読めば請求の担当だと分かりますが、この判断をAPIに任せてみます。
判断基準と選択肢を書く
以下は、そのままコピーして試せる最小構成のコードです。choice.mjsとして保存します。
import OpenAI from 'openai';
// 環境変数 OPENAI_API_KEY を読み込みます。
const client = new OpenAI({ timeout: 10_000, maxRetries: 0 });
const decision = await client.decisions.create({
model: 'gpt-6-luna',
input: '注文の代金が二重に請求されました',
questions: [{
type: 'choice',
name: 'department',
instructions: '問い合わせに最も適した担当部署を1つ選ぶ',
choices: [
{ value: 'billing', description: '請求・支払い・返金' },
{ value: 'technical', description: '不具合・操作方法' },
{ value: 'shipping', description: '配送状況・荷物の紛失' },
{ value: 'other', description: '上記に当てはまらない内容' },
],
}],
});
const answer = decision.answers.find((item) => item.name === 'department');
console.log(JSON.stringify(answer, null, 2));
console.log('使用トークン:', decision.usage);
// 0.7はデモ用。実際のデータで調整します。
if (answer?.type !== 'choice' || answer.confidence NOTE
>
> `apiKey`を省略すると、APIキーは環境変数から自動で読み込まれます。
>
> 1. `node --env-file=.env.local choice.mjs`で、Node.jsが`OPENAI_API_KEY`を環境変数に設定します。
> 2. OpenAI SDKの`new OpenAI()`が、その環境変数を参照します。
リクエストの中心は`model`・`input`・`questions`の3つです。`questions`に書く`instructions`が判断基準で、`choices`が選べる候補です。`value`はコードで使う識別子、`description`は各候補の意味をモデルに伝える説明です。
`name`は質問と回答を対応づけるために使います。この例では`department`という名前で回答を取り出しています。
> 参考: [リクエストのリファレンス](https://developers.openai.com/api/reference/typescript/resources/decisions/methods/create)
### 返ってきた値をアプリで使う
下の画面は、今回作成した紹介用スライドの一部です。選択結果に応じて担当部署の表示を切り替えました。
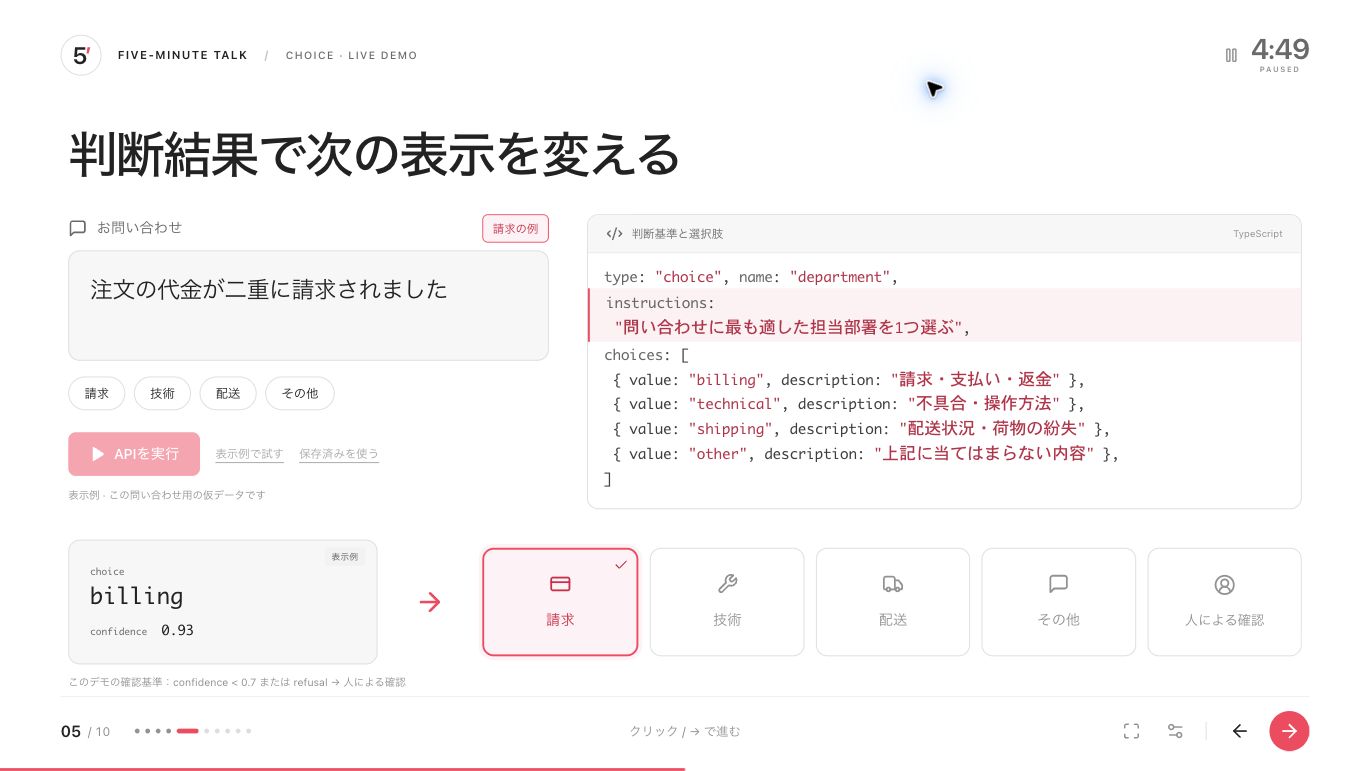
> NOTE: 上の画面の`choice: billing`、`confidence: 0.93`は、画面説明用の仮データです。実際の応答値や速度の測定結果ではありません。
APIが返した選択結果に応じて、次に何をするかをアプリで決められます。たとえば、`billing`を請求担当のキューに対応づけたり、請求に関する案内ページを表示したりできます。
このサンプルでは`confidence`が0.7未満なら、人による確認に回しています。0.7はデモのための仮値です。
また、`confidence`と各候補の`probabilities`は別のフィールドです。`confidence: 0.93`を、そのまま実運用での正解率93%と読まないようにしましょう。しきい値は誤分類の影響も含めて決めます。
> 参考: [回答の解釈](https://developers.openai.com/api/docs/guides/decisions#interpret-the-answers)
### 11パターンを実際に試した結果
用意した問い合わせ11例を各5回、合計55回実行しました。上のコードと同じ質問・選択肢を使い、1例ずつ順に送信しました。
応答時間は、SDKの呼び出し開始から応答を受信するまでの時間です。通信時間を含みますが、SDKの読み込みやファイル保存の時間は含みません。事前のウォームアップはせず、初回も集計に含めています。
全55件の中央値は208ms、P95は429msでした。最初のリクエストは3,426msで、これが最大値です。初回に時間がかかった原因は切り分けていません。今回の計測では、55件とも通信エラーや回答拒否はありませんでした。
| パターン | `choice` | `confidence` | 入力トークン数 | 中央値 | P95 |
| --- | --- | ---: | ---: | ---: | ---: |
| 二重請求 | `billing` | 1.00 | 176 | 251ms | 3,426ms |
| 返金状況 | `billing` | 1.00 | 188 | 221ms | 379ms |
| ログイン不可 | `technical` | 1.00 | 191 | 194ms | 343ms |
| アプリの不具合 | `technical` | 1.00 | 187 | 208ms | 216ms |
| 配送の遅れ | `shipping` | 1.00 | 192 | 228ms | 536ms |
| 配達済みなのに未着 | `shipping` | 1.00 | 189 | 209ms | 324ms |
| 商品の再入荷 | `other` | 1.00 | 187 | 205ms | 429ms |
| 配送と返金 | `billing` | 0.91 | 190 | 206ms | 217ms |
| 決済エラーと請求 | `billing` | 1.00 | 197 | 216ms | 324ms |
| 情報不足:「うまくいきません」 | `technical` | 0.60 | 178 | 311ms | 389ms |
| 情報不足:「先日の件」 | `other` | 0.93 | 179 | 208ms | 347ms |
各パターンで、5回とも同じ分類結果・`confidence`・入力トークン数が返りました。P95には、応答時間を小さい順に並べ、件数の95%を切り上げた順位の値を使っています。各行は5回だけの計測なので、行ごとのP95は最大値と同じです。
計測に使った問い合わせの全文は次のとおりです。上のコードの`input`を置き換えて試せます。
| パターン | 入力した問い合わせ |
| --- | --- |
| 二重請求 | 注文の代金が二重に請求されました |
| 返金状況 | 先週キャンセルした注文の返金がまだ確認できません。返金状況を教えてください。 |
| ログイン不可 | パスワードを再設定しても、ログインするとエラー画面になります。対処方法を教えてください。 |
| アプリの不具合 | アプリを最新版に更新してから、注文履歴を開くと必ず終了してしまいます。 |
| 配送の遅れ | 昨日届く予定の荷物がまだ届きません。追跡番号の配送状況も更新されていません。 |
| 配達済みなのに未着 | 追跡では配達済みですが、荷物が見当たりません。宅配ボックスにもありません。 |
| 商品の再入荷 | 売り切れになっている青色のマグカップは、いつ再入荷しますか? |
| 配送と返金 | 荷物が予定日を過ぎても届かないので、注文をキャンセルして返金してほしいです。 |
| 決済エラーと請求 | 支払いボタンを押したらエラーが出ました。もう一度試すと注文できましたが、カードに2回請求されています。 |
| 情報不足:「うまくいきません」 | うまくいきません。どうすればいいですか? |
| 情報不足:「先日の件」 | 先日の件、まだ確認できていません。対応をお願いします。 |
表の最初の7例は、5回とも想定した部署に分類されました。複数の用件を含む「配送と返金」の例は`billing`に分類され、`confidence`は0.91でした。今回の質問では、返金希望を請求担当へ振り分ける結果になっています。
情報不足の2例では、結果に違いが出ました。
- 「うまくいきません。どうすればいいですか?」は`technical`、`confidence`は0.60。デモのしきい値0.7では、人による確認へ回ります。
- 「先日の件、まだ確認できていません。対応をお願いします。」は`other`、`confidence`は0.93。こちらは同じしきい値でも人による確認には回りません。
情報が足りない文でも、`confidence`が必ず低くなるわけではないことが分かります。詳細を聞き返す必要がある業務では、しきい値だけに頼らず、「情報不足」という選択肢や、追加確認が必要かを問う質問も検討したいところです。
これは用意した11例・各5回での観察です。実運用全体の正解率や速度を保証するものではなく、Responses APIとの速度比較も行っていません。
## 実践2:画像からへこみを判定する
Decisions APIには画像も入力できます。個人的には、この点がアプリに組み込むうえで面白そうだと思いました。
カップの画像を渡して、「この商品にへこみはある?」と質問してみます。比較しやすいよう、同じカップでへこみの有無が異なる2枚を用意しました。
| へこみなし | へこみあり |
| --- | --- |
|  | 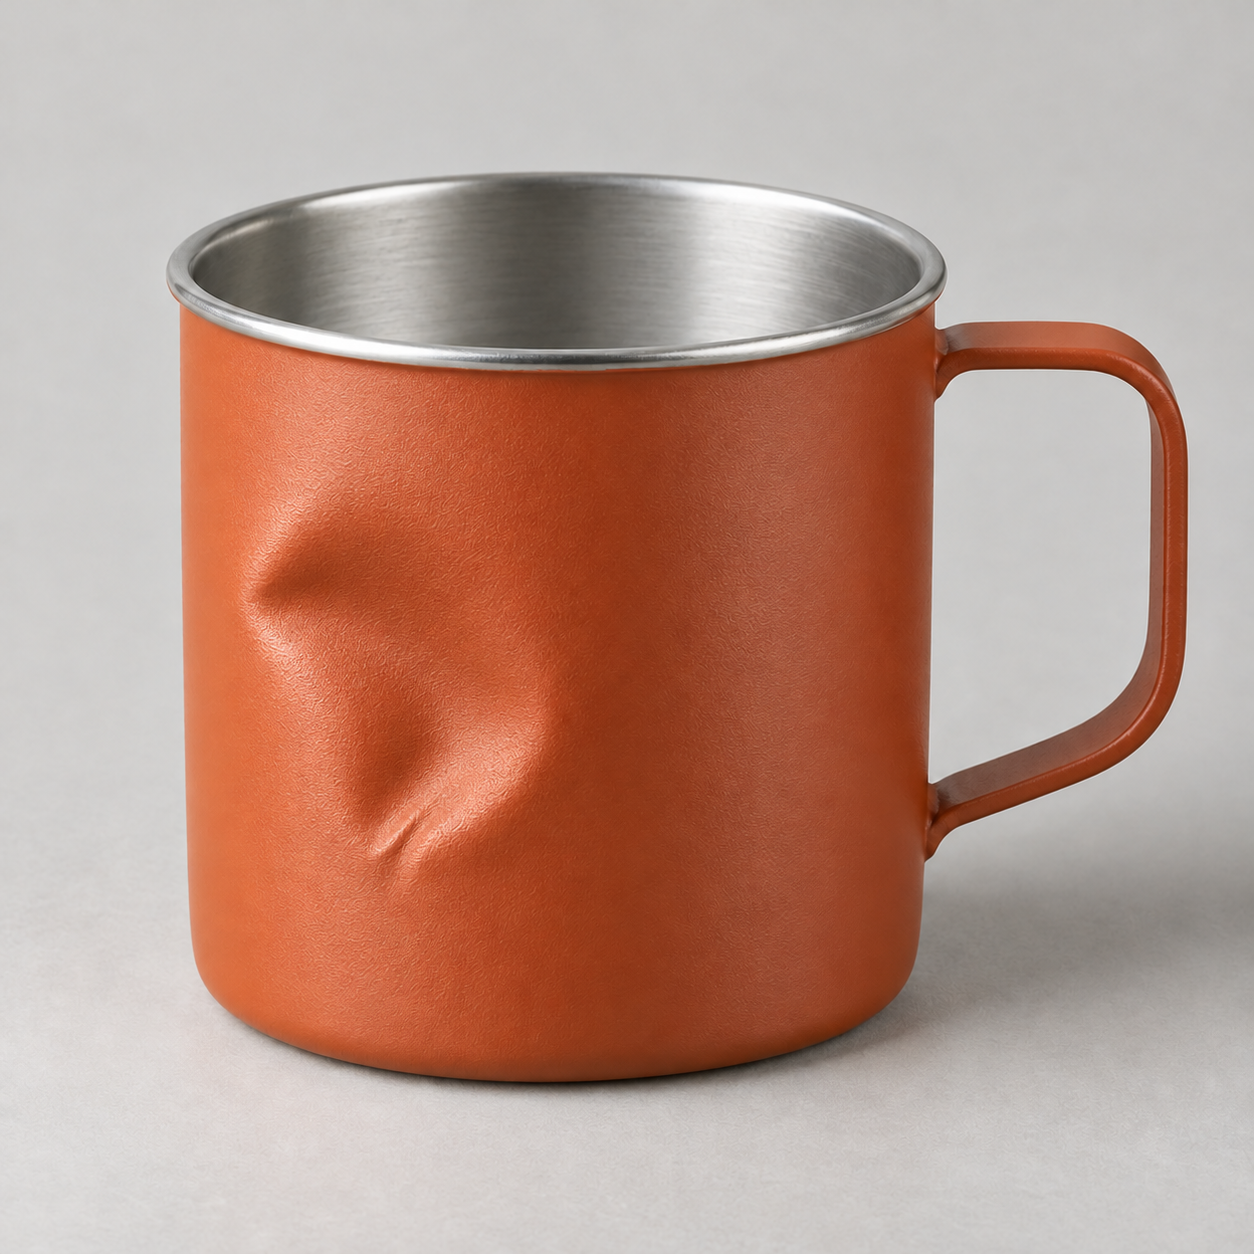 |
> NOTE: この2枚は、この記事の説明用にAIで生成した画像です。
下のコードと同じ条件で、各画像を1回ずつ判定しました。結果はコードの後に載せています。
試す場合は、上の画像を1枚保存するか、手元のPNG画像を用意します。その画像を`choice.mjs`と同じフォルダーに`product.png`という名前で置きます。以下のコードを`predicate.mjs`として保存すれば、その画像を判定できます。2枚を比べるときは、`product.png`を入れ替えてそれぞれ実行してください。
```js
import { readFile } from 'node:fs/promises';
import OpenAI from 'openai';
const client = new OpenAI({ timeout: 10_000, maxRetries: 0 });
const imageBase64 = (await readFile('product.png')).toString('base64');
const decision = await client.decisions.create({
model: 'gpt-6-luna',
input: [{
role: 'user',
content: [
{ type: 'input_text', text: '写真の商品を確認してください。' },
{ type: 'input_image', image_url: `data:image/png;base64,${imageBase64}` },
],
}],
questions: [{
type: 'predicate',
name: 'has_dent',
instructions: '商品本体にへこみがありますか。影や模様はへこみに含めません。',
}],
});
const answer = decision.answers.find((item) => item.name === 'has_dent');
if (answer?.type === 'predicate') {
console.log(`へこみがある推定確率: ${(answer.probability * 100).toFixed(2)}%`);
} else {
console.log('判定結果を取得できなかったため、人による確認へ回します');
}
node --env-file=.env.local predicate.mjs
このコードはPNG用です。JPEGを使う場合はファイル名とdata:image/pngの部分を合わせて変更します。この例では、公式ガイドと同じく画像をBase64のデータURLにして渡しています。
> 参考: 画像入力の例
この2枚での判定結果
上のコードと同じ質問を送りました。応答時間の測り方は、問い合わせ分類の計測と同じです。
| 入力画像 | probability |
入力トークン数 | 応答時間 | 取得日時(日本時間) |
|---|---|---|---|---|
| へこみなし | 0.00 | 1,777 | 1,050ms | 2026-10-15 11:23:46 |
| へこみあり | 1.00 | 1,777 | 709ms | 2026-10-15 11:23:47 |
この実行では、へこみなしの画像には0、へこみありの画像には1が返りました。0と1は今回の入力に対してモデルが返した推定値です。
あとはprobabilityにしきい値を設ければ、確認が必要そうな写真を人に回す処理を作れます。どの値から確認対象にするかは、見逃しと過剰な検出のどちらをどこまで許容するかで変わります。
score:破損の程度を評価する
「壊れているか」に加えて、「どのくらい壊れているか」を扱いたいときはscoreを使います。
荷物の写真なら、評価基準を次のように定義できます。これはquestionsに指定する質問の例です。
const damageQuestion = {
  type: 'score',
  name: 'damage_level',
  instructions: '荷物の梱包に見られる破損の程度を評価してください。',
  levels: [
    { label: '破損なし', description: '目立つへこみや破れがない' },
    { label: '軽度', description: 'へこみや擦れはあるが、梱包の形は保たれている' },
    { label: '重度', description: '大きな潰れや破れがあり、梱包の形が崩れている' },
  ],
};
この例を試すときは、product.pngを荷物の梱包の状態が分かるPNG画像に差し替えます。画像入力のコードで、questionsを[damageQuestion]に変更します。回答はname: 'damage_level'で取り出し、type === 'score'を確認してscoreを読みます。
levelsの番号は先頭から0、1、2です。返ってくるscoreは、その番号を各段階の確率で重み付けした平均値なので、小数になることもあります。
計算例として、確率の並びが[0.0, 1.0, 0.0]の場合を考えます。軽度の確率が1.0なので、スコアは次の計算で1.0になります。
0 × 0.0 + 1 × 1.0 + 2 × 0.0 = 1.0
このスコアは物理的に「何%壊れているか」を測った値ではなく、指定した段階に沿った評価です。
> 参考: スコアの計算方法
predicateで破損の可能性を調べ、確認対象になった場合だけscoreで程度を評価する使い方もできそうです。
開発フローでの活用案
アプリへの組み込み以外にも、コード変更の確認に使えないかなーと考えました。
たとえば、コードの差分と設計規約を渡して、「画面表示のコードに業務ルールが混ざっていないか」を評価させる使い方です。コードを変更した後にフックやCIから呼び出し、結果に応じて追加修正やレビューにつなげられそうです。
> NOTE: これは考えたはいいものの、実用性はなんとも言えないので試していません。
料金の目安
Decisions APIのgpt-6-lunaは、入力100万トークンあたり$0.10です。出力トークンの料金はかかりません。この単価は/v1/decisions向けで、同じモデルを別のAPIから使う場合とは料金体系が異なります。
> 参考: Decisions APIの料金
1回の入力が500トークンだと仮定すると、次の計算になります。
1回の料金 = 500 × $0.10 ÷ 1,000,000 = $0.00005
$5で使える回数 = $5 ÷ $0.00005 = 100,000回
| 入力トークン / 回 | 料金 / 回 | $5での回数 |
|---|---|---|
| 500 | $0.00005 | 約100,000回 |
| 1,000 | $0.0001 | 約50,000回 |
| 5,000 | $0.0005 | 約10,000回 |
| 10,000 | $0.001 | 約5,000回 |
500トークンは計算用の仮定です。入力には問い合わせ本文だけでなく、判断基準や選択肢、画像なども含まれます。実際の使用トークン数は、コードで表示したdecision.usageを確認してください。
表は標準単価での概算で、地域処理や長い入力への追加料金は含みません。
今回のカップ画像の判定では、画像や質問文を含む入力全体で1回1,777トークンでした。同じ標準単価なら1回あたり$0.0001777、$5で約28,100回の計算で、表の500トークンの例より回数は少なくなります。画像や質問文が変わると、入力トークン数や使える回数も変わります。
入力が短い用途なら、少額から試せそうです。個人的には、アプリに小さな判定処理を足すときに使いやすそうな料金だと感じました。
Jevとの比較
判断結果をコードで使うAPIとしては、TypeSafeのJevもあります。ここでは、安定版jev-1.13.0を基準に比較します。
| 比較項目 | Decisions API | Jev |
|---|---|---|
| 比較するモデル | gpt-6-luna |
jev-1.13.0 |
| 入力 | テキスト・画像 | テキスト(画像は実験的に対応) |
| 入力100万トークンの標準料金 | $0.10 | $0.042 |
| 出力料金 | 無料 | 無料 |
> NOTE
>
> なんと、Jevにも画像入力が実験的に追加されたようです。10月14日のJev 1.14の発表では、1.13でも専用ヘッダーで有効にできると案内されています。
>
> 2026年10月15日の確認時点では、Jev 1.14の料金は1.13と同じです。公式一覧ではjev-latestが1.13、jev-previewが1.14を指しています。モデルを固定して比較したい場合は、この違いも確認しておきましょう。
>
> 参考: OpenAIの料金説明
> 参考: TypeSafeのモデルとエイリアス
> 参考: Jev 1.14と画像入力の発表
同じ課金トークン数で比べると、JevはDecisions APIより入力料金が58%安い計算です。ただし、同じ文章でも課金トークン数が一致するとは限らないため、同じ処理の費用がそのまま58%下がるとは言えません。精度や応答時間も含めて、自分たちの入力で比べたいところです。
画像を使う用途では、Decisions APIも候補になります。写真から得た判断を、そのままアプリの操作や案内につなげられるのは面白そうです。
まとめ
個人的には、開発中のチェックよりも、アプリに組み込むほうに興味があります。
特にXR端末などで撮影した写真を使えたら、現場での確認や案内に応用できそうです。この使い方はまだアイデアの段階ですが、テキストだけの問い合わせ分類とは違う使い道を考えたくなりますね。
まずは、いつも人が判断している処理を1つ選び、入力と選択肢を用意して試してみると、アプリへの組み込み方を考えやすいと思います。
それでは、また次の開発で!
